En esta práctica se monta una arquitectura profesional de observabilidad que permite monitorizar sistemas en tiempo real. Se construye un stack completo con tres componentes clave:
- OpenTelemetry Collector: recolector universal de métricas desde múltiples fuentes (aplicaciones, sistemas operativos, contenedores).
- Prometheus: motor de almacenamiento eficiente en base de datos de series temporales (TSDB) y consulta de datos mediante lenguaje PromQL.
- Grafana: interfaz de visualización con dashboards interactivos y alertas configurables.
Este tipo de infraestructura es utilizada por empresas como Google (Borgmon), Netflix, Amazon (CloudWatch), Spotify, Uber y Airbnb para monitorizar sus sistemas de producción a escala global.
Estructura del proyecto
Organizar el proyecto en una estructura clara:
1mkdir -p ~/herramientas
2cd ~/herramientas
3
4mkdir -p grafana/datasources
5mkdir -p grafana/dashboards
6mkdir -p opentelemetry
7mkdir -p prometheus
Configuración de servicios
Archivo docker-compose.yaml
Creamos el archivo principal de orquestación:
1nano docker-compose.yaml
 1services:
 2  prometheus:
 3    image: prom/prometheus:latest
 4    container_name: prometheus
 5    ports:
 6      - "9090:9090"
 7    volumes:
 8      - ./prometheus/prometheus.yaml:/etc/prometheus/prometheus.yml
 9      - prometheus-data:/prometheus
10    command:
11      - '--config.file=/etc/prometheus/prometheus.yml'
12      - '--storage.tsdb.path=/prometheus'
13      - '--web.console.libraries=/usr/share/prometheus/console_libraries'
14      - '--web.console.templates=/usr/share/prometheus/consoles'
15    networks:
16      - monitoring
17    restart: unless-stopped
18
19  otel-collector:
20    image: otel/opentelemetry-collector-contrib:latest
21    container_name: otel-collector
22    ports:
23      - "4317:4317"
24      - "4318:4318"
25      - "8888:8888"
26      - "8889:8889"
27    volumes:
28      - ./opentelemetry/opentelemetry.yml:/etc/otel/config.yaml
29    command: ["--config=/etc/otel/config.yaml"]
30    networks:
31      - monitoring
32    restart: unless-stopped
33
34  grafana:
35    image: grafana/grafana:latest
36    container_name: grafana
37    ports:
38      - "3000:3000"
39    volumes:
40      - grafana-data:/var/lib/grafana
41      - ./grafana:/etc/grafana/provisioning
42    environment:
43      - GF_SECURITY_ADMIN_USER=admin
44      - GF_SECURITY_ADMIN_PASSWORD=********
45      - GF_USERS_ALLOW_SIGN_UP=false
46    networks:
47      - monitoring
48    restart: unless-stopped
49    depends_on:
50      - prometheus
51
52  app-demo:
53    image: nginx:alpine
54    container_name: app-demo
55    ports:
56      - "8080:80"
57    networks:
58      - monitoring
59    restart: unless-stopped
60
61volumes:
62  prometheus-data:
63  grafana-data:
64
65networks:
66  monitoring:
67    driver: bridge
Explicación del yaml:
Servicio prometheus:
image: Imagen oficial de Prometheusports: Expone la interfaz web en el puerto 9090volumes: configuración (./prometheus/prometheus.yaml→/etc/prometheus/prometheus.yml) y datos persistentes (prometheus-data→/prometheus)command: parámetros de inicio —--config.file(ubicación del archivo de configuración) y--storage.tsdb.path(directorio de almacenamiento TSDB)networks: conecta a la red internamonitoringrestart: reinicia automáticamente salvo parada manual
Servicio otel-collector:
ports:4317(protocolo OTLP sobre gRPC),4318(OTLP sobre HTTP),8888(métricas internas del collector),8889(endpoint para scraping de Prometheus)volumes: monta la configuración del collector
Servicio grafana:
ports: interfaz web en el puerto 3000environment:GF_SECURITY_ADMIN_USER(usuario administrador),GF_SECURITY_ADMIN_PASSWORD(contraseña inicial),GF_USERS_ALLOW_SIGN_UP(deshabilita el registro público)depends_on: indica dependencia de Prometheus
Servicio app-demo: Nginx Alpine, servidor web ligero para generar tráfico de prueba.
Volúmenes: prometheus-data (persistencia de métricas históricas) y grafana-data (persistencia de configuración y dashboards).
Redes: monitoring, red bridge interna para comunicación entre contenedores.
Configuración de Prometheus
Creamos el archivo de configuración:
1nano prometheus/prometheus.yaml
 1global:
 2  scrape_interval: 15s
 3  evaluation_interval: 15s
 4
 5  external_labels:
 6    monitor: 'monitoring-stack'
 7    environment: 'development'
 8
 9scrape_configs:
10  - job_name: 'prometheus'
11    static_configs:
12      - targets: ['localhost:9090']
13        labels:
14          service: 'prometheus'
15
16  - job_name: 'otel-collector'
17    static_configs:
18      - targets: ['otel-collector:8888']
19        labels:
20          service: 'otel-collector'
21
22  - job_name: 'otel-metrics'
23    static_configs:
24      - targets: ['otel-collector:8889']
25        labels:
26          service: 'otel-exported-metrics'
Explicación de la configuración:
global.scrape_interval: cada cuánto Prometheus recoge métricas de los targets (15s)global.evaluation_interval: cada cuánto evalúa las reglas de alertas (15s)global.external_labels: etiquetas que se añaden a todas las métricas (útil para identificar el origen)scrape_configs: lista de fuentes de métricas (jobs), cada uno conjob_name(identificador único),static_configs(configuración estática, sin descubrimiento dinámico),targets(endpoints donde hará scraping) ylabels(etiquetas adicionales)
Cómo funciona el scraping:
- Prometheus hace peticiones HTTP GET a cada target cada 15 segundos
- Los targets exponen métricas en formato texto plano
- Prometheus parsea y almacena las métricas en su base de datos de series temporales (TSDB)
Configuración de OpenTelemetry Collector
Creamos el archivo de configuración:
1nano opentelemetry/opentelemetry.yml
 1receivers:
 2  otlp:
 3    protocols:
 4      grpc:
 5        endpoint: 0.0.0.0:4317
 6      http:
 7        endpoint: 0.0.0.0:4318
 8
 9  prometheus:
10    config:
11      scrape_configs:
12        - job_name: 'app-demo-nginx'
13          scrape_interval: 10s
14          static_configs:
15            - targets: ['app-demo:80']
16
17  hostmetrics:
18    collection_interval: 30s
19    scrapers:
20      cpu:
21      memory:
22      disk:
23      network:
24      load:
25      filesystem:
26
27processors:
28  batch:
29    timeout: 10s
30    send_batch_size: 1024
31
32  resource:
33    attributes:
34      - key: service.instance.id
35        value: otel-collector-01
36        action: insert
37      - key: deployment.environment
38        value: development
39        action: insert
40
41exporters:
42  prometheus:
43    endpoint: "0.0.0.0:8889"
44    namespace: "otel"
45    const_labels:
46      collector: "otel-collector"
47
48  debug:
49    verbosity: detailed
50
51  prometheusremotewrite:
52    endpoint: "http://prometheus:9090/api/v1/write"
53    tls:
54      insecure: true
55
56service:
57  pipelines:
58    metrics:
59      receivers: [otlp, prometheus, hostmetrics]
60      processors: [batch, resource]
61      exporters: [prometheus, debug, prometheusremotewrite]
62
63  telemetry:
64    logs:
65      level: info
Flujo de datos:
- Las métricas entran por cualquiera de los 3 receivers (
otlp,prometheus,hostmetrics) - Pasan por el procesador
batch - Pasan por el procesador
resource - Se exportan simultáneamente a los 3 exportadores
Configuración de Grafana
Creamos la configuración de la fuente de datos:
1nano grafana/datasources/prometheus.yml
 1apiVersion: 1
 2
 3datasources:
 4  - name: Prometheus
 5    type: prometheus
 6    access: proxy
 7    url: http://prometheus:9090
 8    isDefault: true
 9    editable: true
10    jsonData:
11      timeInterval: "15s"
12      httpMethod: POST
Explicación:
apiVersion: 1: versión del formato de provisiónname: Prometheus: nombre de la fuente de datos en Grafanatype: prometheus: tipo de fuente de datosaccess: proxy: Grafana hace las peticiones (no el navegador)url: URL interna de Prometheus (nombre del servicio Docker)isDefault: true: fuente de datos por defectoeditable: true: permite editar desde la UItimeInterval: "15s": intervalo mínimo entre queries (coincide con elscrape_interval)httpMethod: POST: usar POST para queries largas (más eficiente)
Configuración de provisión de dashboards
Creamos la configuración de provisión:
1nano grafana/dashboards/dashboard.yml
 1apiVersion: 1
 2
 3providers:
 4  - name: 'Default'
 5    orgId: 1
 6    folder: ''
 7    type: file
 8    disableDeletion: false
 9    updateIntervalSeconds: 10
10    allowUiUpdates: true
11    options:
12      path: /etc/grafana/provisioning/dashboards
Explicación:
providers: lista de proveedores de dashboardsname: 'Default': nombre del proveedororgId: 1: organización de Grafanafolder: '': carpeta donde aparecerán los dashboardstype: file: los dashboards se cargan desde archivosdisableDeletion: false: permite borrar dashboards desde la UIupdateIntervalSeconds: 10: cada cuánto busca nuevos dashboardsallowUiUpdates: true: permite editar dashboards desde la UIpath: ruta donde busca los archivos JSON de dashboards
Dashboard de sistema
Creamos el dashboard básico:
1nano grafana/system.json
El dashboard define 4 paneles sobre la fuente de datos de Prometheus, cada uno con su propia query PromQL, umbrales de color y tipo de visualización:
CPU Usage (%) — gráfico de series temporales
- Query:
100 - (avg by (instance) (rate(otel_system_cpu_time_seconds_total{state="idle"}[1m])) * 100) - Cálculo: 100% − tiempo en idle = tiempo activo de CPU
- Umbrales: verde (<70%), amarillo (70-85%), rojo (>85%)
- Query:
Memory Usage (%) — gauge (medidor)
- Query:
(otel_system_memory_usage_bytes{state="used"} / otel_system_memory_usage_bytes) * 100 - Muestra el porcentaje de memoria usada
- Umbrales: verde (<70%), amarillo (70-90%), rojo (>90%)
- Query:
Network I/O — gráfico de series temporales
- Query RX:
rate(otel_system_network_io_bytes_total{direction="receive"}[1m]) - Query TX:
rate(otel_system_network_io_bytes_total{direction="transmit"}[1m]) - Muestra bytes/segundo recibidos y transmitidos
- Query RX:
Disk Usage (%) — bar gauge (barras horizontales)
- Query:
(otel_system_filesystem_usage_bytes{state="used"} / otel_system_filesystem_usage_bytes) * 100 - Muestra el uso de disco por dispositivo/punto de montaje
- Query:
El JSON completo del dashboard (paneles, fieldConfig, umbrales y queries) se guarda tal cual en grafana/system.json para que Grafana lo importe en el siguiente paso.
Despliegue del stack
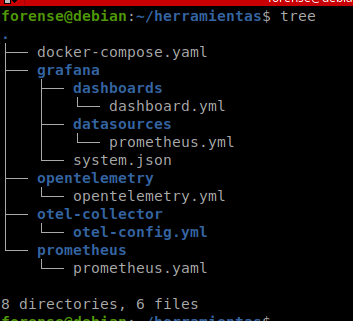
Antes de desplegar, verificamos que todos los archivos estén en su sitio:
1cd ~/herramientas
2tree
Levantar servicios
Vamos a iniciar todos los contenedores:
1docker compose up -d
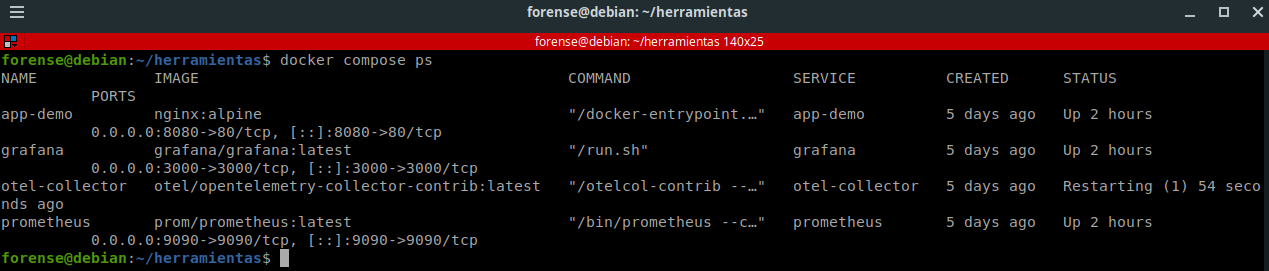
Para ver que se han iniciado correctamente:
1docker compose ps
Uso del stack de monitorización
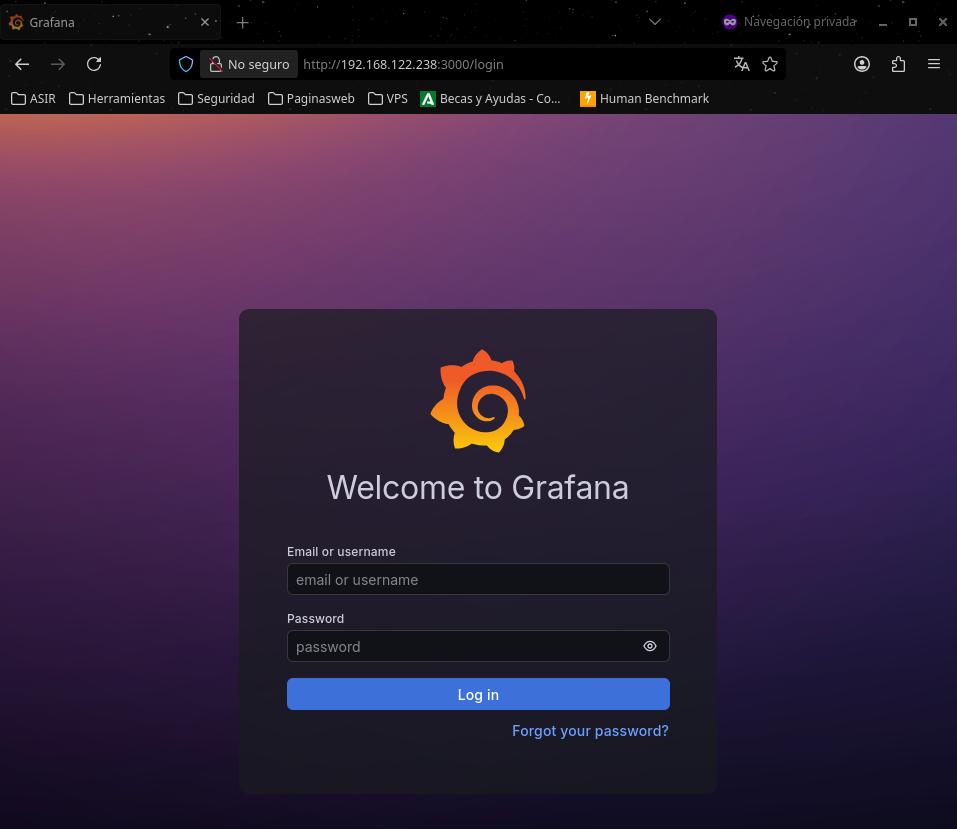
Vamos a acceder a Grafana, poniendo la IP donde tenemos alojado nuestro servidor y el puerto 3000:
Y ahora nos aparecerá un panel lateral a la izquierda; vamos a darle en ese panel a Dashboards → New:
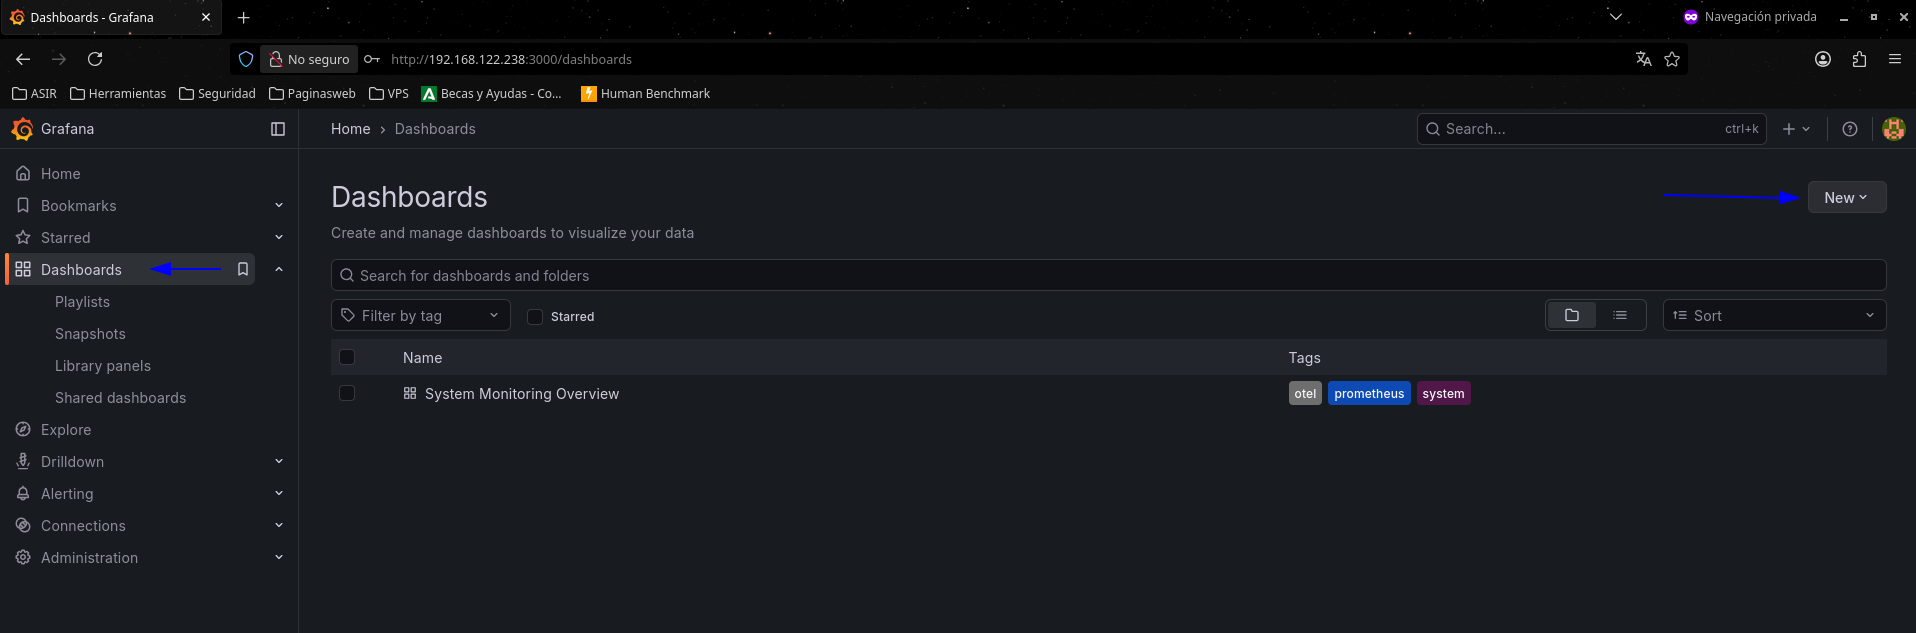
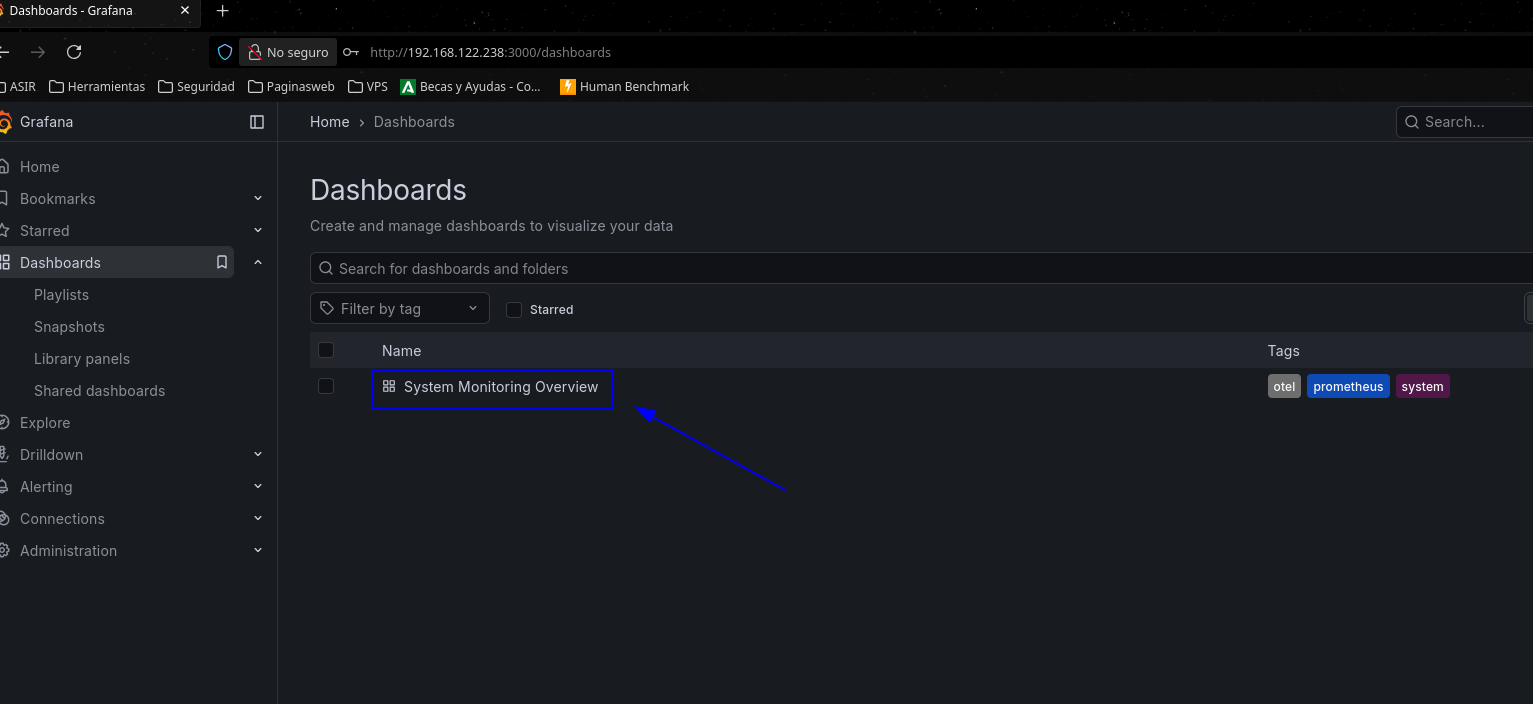
E importamos nuestro fichero .json que creamos anteriormente; una vez importado, nos aparecerá en el panel:
Entonces vemos cómo monitorizamos nuestro servidor: la CPU, la RAM, el disco y la red.
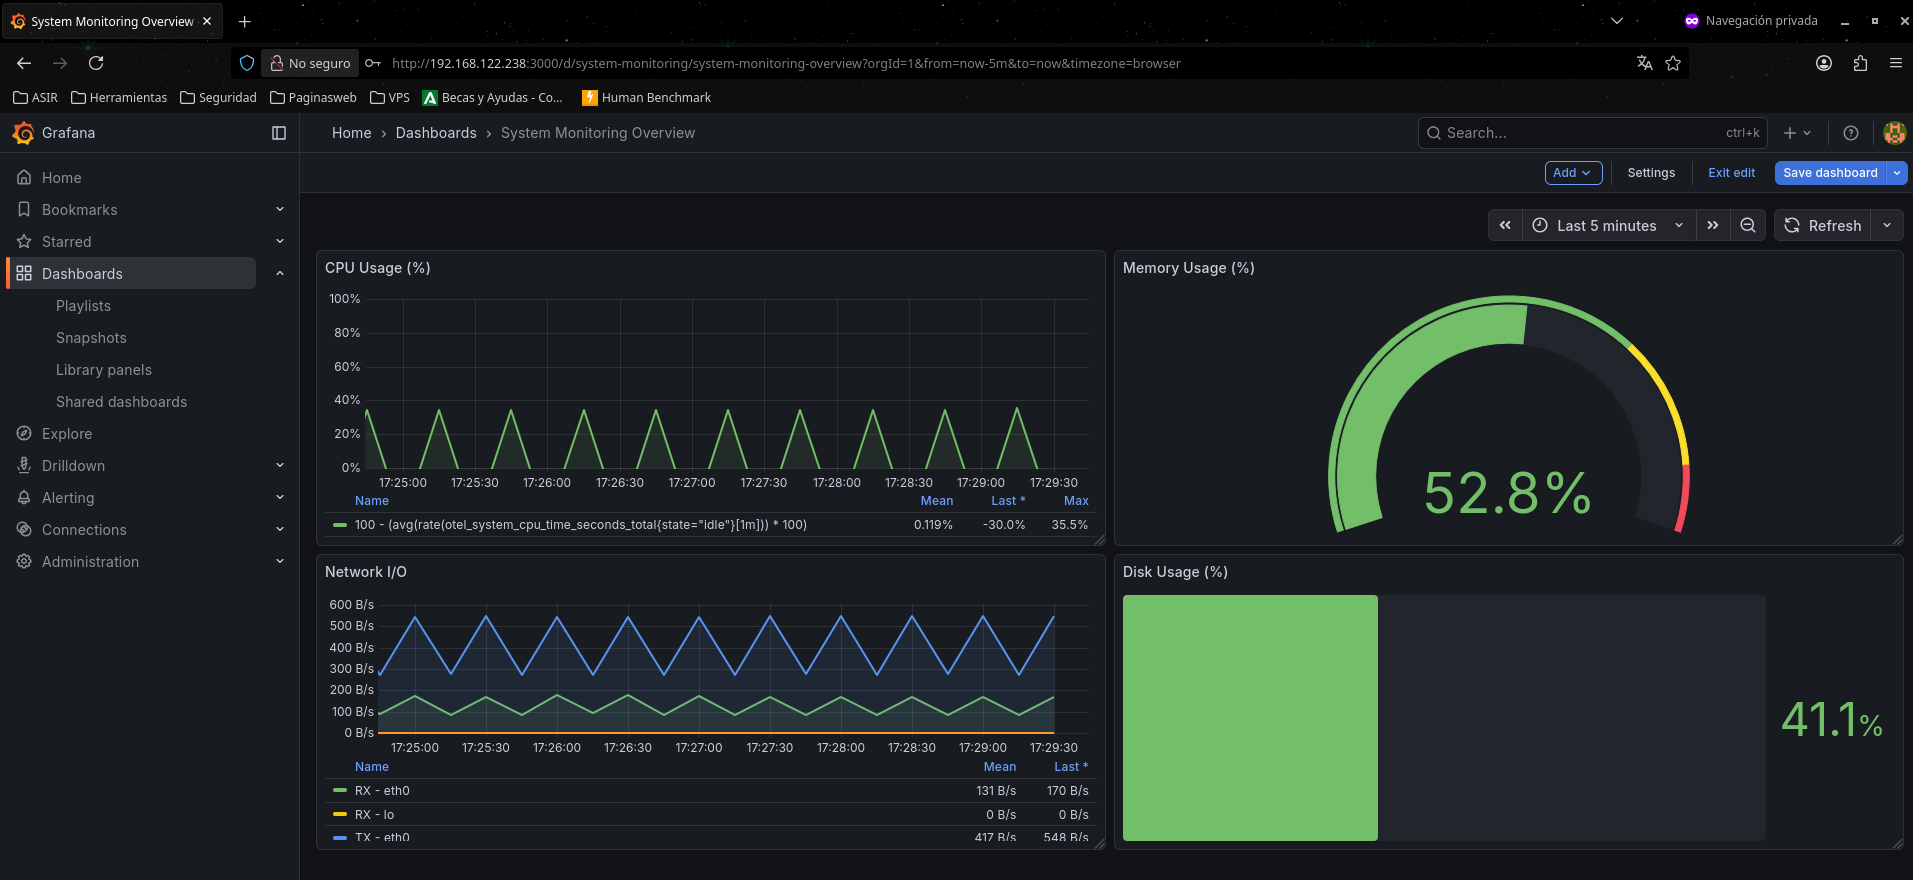
Como vemos, OpenTelemetry recoge las métricas de tu servidor, Prometheus las guarda y Grafana las muestra en gráficos.